2026년 9월 중순 타입세이프(TypeSafe) AI가 글을 쓰지 않고 '고르기만' 하는 AI 모델 제브(Jev)를 내놓았고, 10월 6일에는 오픈AI도 비슷한 디시전 API(Decisions API)를 모든 개발자에게 열었습니다. 제브가 무엇인지, 요금과 한계는 어떤지, 오픈AI 쪽과 무엇이 다른지 공식 자료로 정리하고, 제 맥에서 3주 동안 붙여 쓴 기록을 함께 적었습니다.
3줄 요약
- 제브는 문장을 만들지 않고, 미리 정한 보기 중 하나와 그 확률만 돌려주는 '판단 전용' 모델입니다.
- 요금은 입력 100만 토큰당 0.042달러이고 출력은 무료입니다. 오픈AI 디시전 API는 같은 기준 0.10달러이고 이미지도 받습니다.
- 3주 동안 댓글·메일 분류와 글 검사에 써 보니 빠르고 거의 공짜였지만, 기준선 근처 값은 판정마다 조금씩 흔들렸습니다.
제브(Jev)는 어떤 AI인가요?
상황(state)과 질문을 넣으면 정해 둔 형식의 답과 확률을 돌려주는 모델입니다. 챗GPT처럼 자유롭게 글을 쓰지는 못합니다.
만든 곳은 오픈AI 연구원 출신 디오고 알메이다(Diogo Almeida)가 세운 타입세이프 AI입니다. 회사는 제브를 '시스템 원(System One) 모델'의 첫 번째라고 부릅니다. 빠르고 직관적인 사고를 뜻하는 '시스템 1'에서 따온 이름입니다. 발표문은 제브를 이렇게 설명합니다.
"Think of Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out."
(제브를 최첨단 지능을 가진 함수 호출이라고 생각하세요. 정리되지 않은 상태가 들어가고, 형식이 정해진 확률적 판단이 나옵니다.)
- TypeSafe 'Introducing System One Models & Jev'
질문 형식은 세 가지입니다. 보기 중 하나를 고르는 choice, 정해 둔 단계 중 어디에 해당하는지 매기는 score, 어떤 문장이 참일 확률을 내는 noul입니다. 답이 처음부터 정해진 틀 안에서만 나오기 때문에, 회사는 형식이 틀린 답(타입 오류)은 나올 수 없다고 말합니다. 테크크런치도 사용자가 출력을 미리 정하므로 환각을 낼 수 없다고 소개했습니다. 다만 틀 안에서 잘못된 보기를 고를 수는 있으니 '틀리지 않는다'는 뜻은 아닙니다.
요금과 사용 조건은 어떻게 되나요?
입력 토큰에만 돈을 받고 출력은 무료입니다. 한 번에 넣을 수 있는 분량은 6만 4천 토큰이고, 지금은 글자만 받습니다.
타입세이프 공식 문서의 모델 페이지 기준으로 현재 버전은 Jev 1.13(jev-1.13.0)이고, 가격은 입력 100만 토큰당 0.042달러, 10억 토큰당 42달러입니다. 사용 제한은 초당 10만 토큰, 초당 80회 요청인데, 수요가 몰려 이 값이 예고 없이 바뀔 수 있다고 적혀 있습니다. 이미지·음성·영상은 아직 넣을 수 없습니다.
한국어 사용자에게 중요한 문장도 있습니다. 문서는 영어가 주된 학습 언어라 정확도가 가장 높고, 한중일 문자를 포함한 다른 언어는 처리하지만 같은 수준은 아니니 직접 시험해 보라고 안내합니다. 오픈라우터(OpenRouter)에도 같은 가격으로 올라와 있습니다.
오픈AI 디시전 API와는 무엇이 다른가요?
하는 일은 거의 같지만 오픈AI 쪽은 이미지를 받는 대신 값이 두 배 넘게 비쌉니다. 둘 다 출력 토큰 요금은 없습니다.
오픈AI는 9월 29일 데브데이에서 디시전 API를 제한 미리보기로 처음 소개했고, 10월 6일 모든 개발자에게 공개 베타로 열었습니다. 더 뉴 스택은 이를 제브에 대한 오픈AI의 대응으로 보도했습니다.
| 항목 | 제브(Jev 1.13) | 오픈AI 디시전 API |
| 입력 요금(100만 토큰당) | 0.042달러 | 0.10달러(gpt-6-luna) |
| 출력 요금 | 무료 | 없음(캐시 요금도 없음) |
| 입력 종류 | 글자만 | 글자와 이미지 |
| 답 형식 | choice, score, noul | predicate, choice, score |
| 속도(회사 주장) | 70ms~500ms | Responses API로 루나를 부를 때보다 최대 10배 빠름 |
| 한 번에 넣는 분량 | 6만 4천 토큰 | 확인하지 못했습니다 |
어느 쪽이 더 정확한지는 공인된 비교가 아직 없습니다. 오픈AI 개발자 커뮤니티에 한 개발자가 수백 개 질문으로 돌려 본 결과를 올렸는데, 미묘한 판단에서는 제브가 더 정확했고 단순한 사실 확인에서는 비슷했다고 합니다. 본인도 '일반 벤치마크가 아니다'라고 적었으니 참고로만 보시면 됩니다. 디시전 API가 한국어를 얼마나 잘 처리하는지도 확인하지 못했습니다.
직접 써보니 어땠나요?
작은 판단을 여러 번 맡기는 일에는 빠르고 거의 공짜였습니다. 대신 값이 기준선 근처면 판정이 조금씩 흔들렸습니다.
9월 20일 제 맥의 AI 비서 Aside에게 제브가 뭔지 물어본 것이 시작이었습니다. 이후 3주 동안 Aside와 디스코드 비서 '오모냥'이 제 지시를 받아 코드를 고치고 돌렸고, 아래 숫자는 그 실행 기록에서 옮겼습니다. 사진은 실제 화면 캡처가 아니라 명령 출력과 기록 파일 내용을 터미널 모양으로 다시 그린 것이고, 댓글 단 분들의 아이디는 가렸습니다.
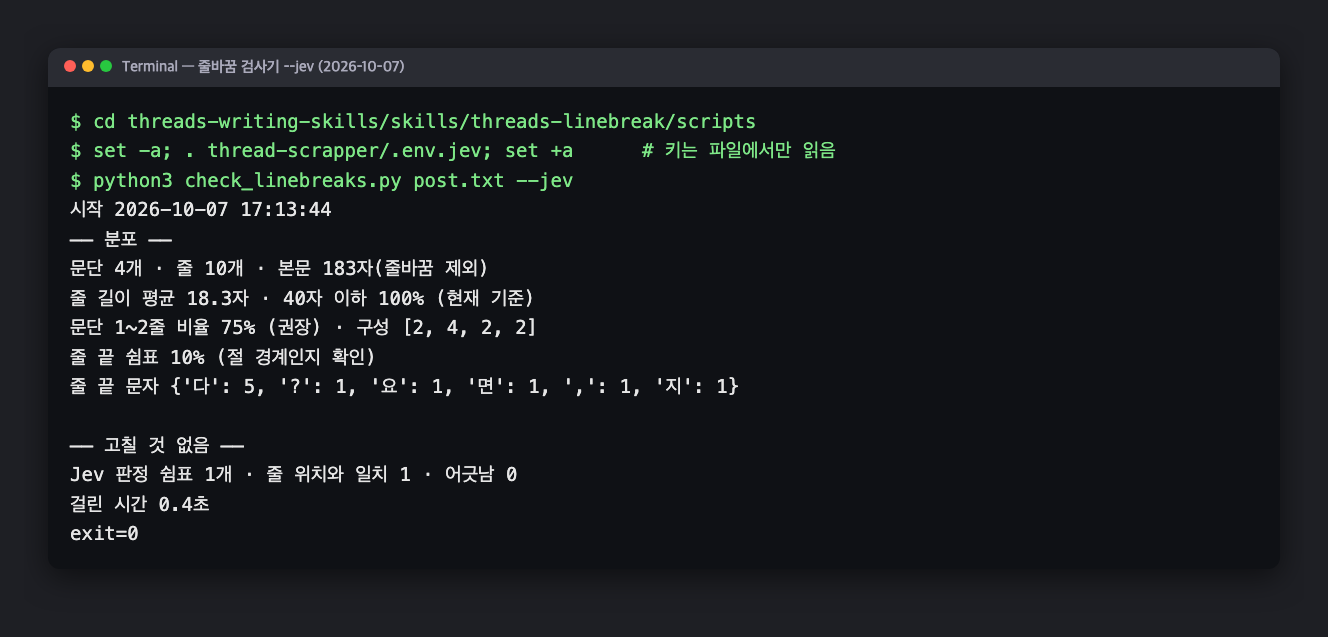
첫 번째로 붙인 곳은 제가 스레드 글을 올리기 전에 돌리는 줄바꿈 검사기입니다. 9월 23일 --jev 옵션을 넣어, 쉼표마다 '문장 사이 경계인지, 단순 나열인지'를 제브가 판정하게 했습니다. 사람이 미리 정답을 달아 둔 쉼표 46개로 맞춰 보니 89.1%가 일치했고, 확신도 0.7 이상만 추리면 96.8%였습니다. 다만 표본이 작아 참고치로만 보기로 했고, 사람도 판정을 못 정한 쉼표가 3개 있었습니다. 10월 7일 공개 글 한 편을 다시 검사했을 때는 0.4초가 걸렸습니다.
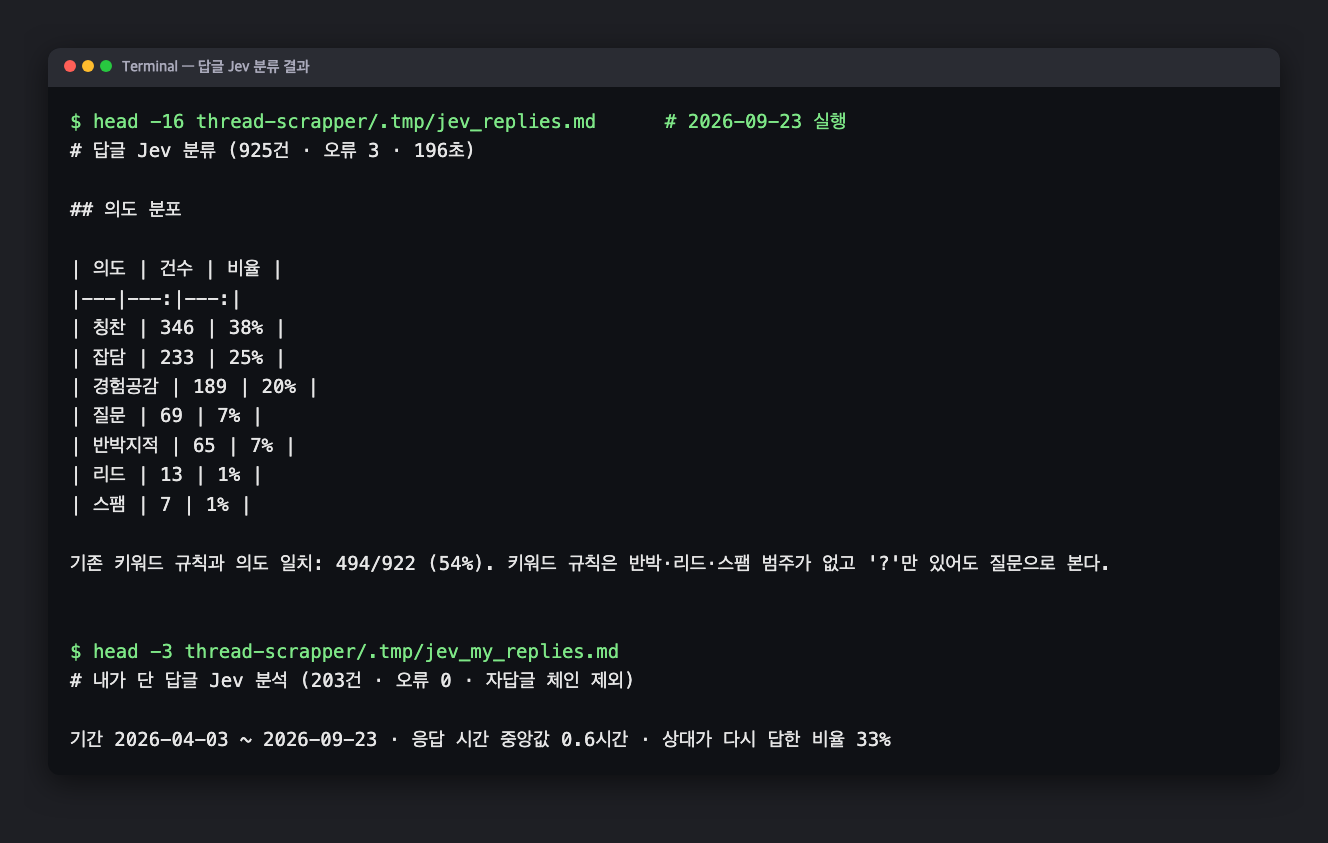
두 번째는 지난 댓글 분류였습니다. 다른 분들이 제 글에 단 답글 925개를 196초 만에 나눴고, 오류는 3건이었습니다. 칭찬 38%, 잡담 25%, 경험 공감 20%, 질문 7%, 반박·지적 7%, 문의(리드) 1%, 스팸 1%였습니다. 전에 쓰던 키워드 규칙과 의도가 같은 것은 54%뿐이었는데, 키워드 규칙에는 반박·문의·스팸 칸이 없고 물음표만 있어도 질문으로 봤기 때문입니다. 어느 쪽이 맞는지는 결국 사람이 봐야 했습니다.
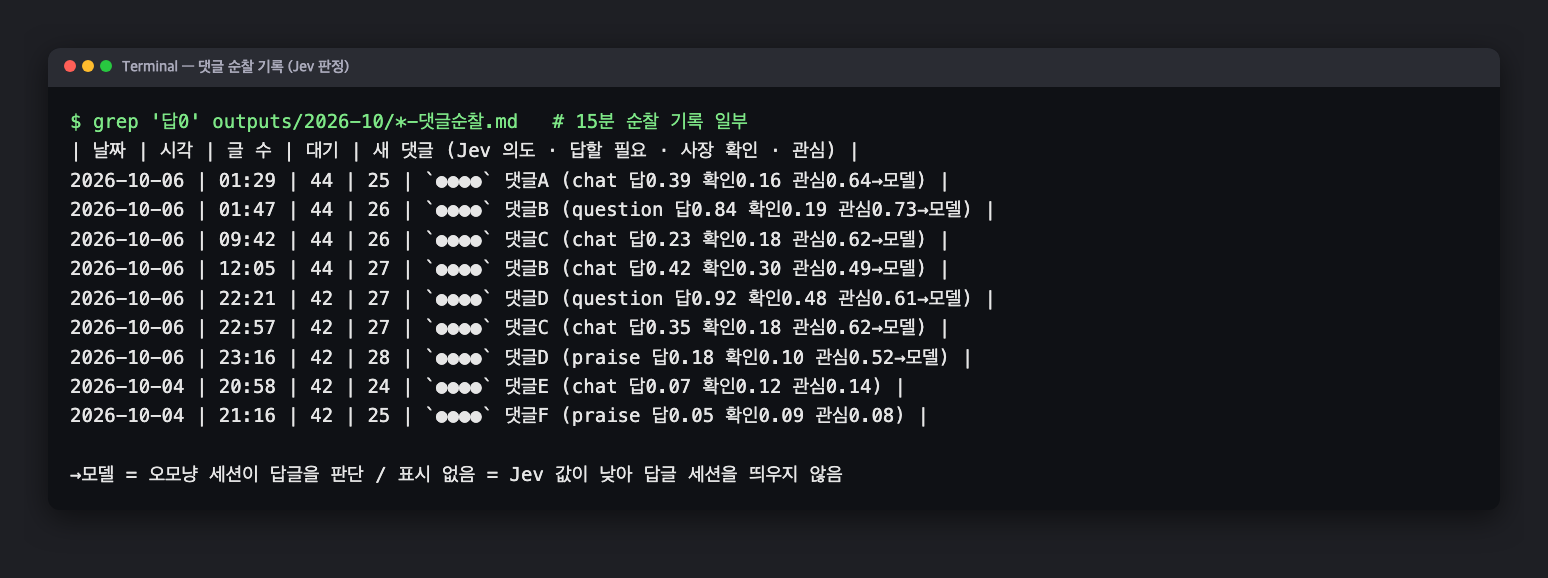
세 번째는 새 댓글 자동 응답입니다. 10월 초부터 새 댓글마다 제브가 의도와 '답할 필요', '사장 확인', '관심' 확률을 매기고, 그 값으로 답글을 달지, 넘길지, 저에게 물을지 나눕니다. 10월 1일부터 7일까지 판정이 붙은 새 댓글은 21건이었고, 13건은 답글 판단으로 넘어갔고 8건은 값이 낮아 넘기지 않았습니다. 영상을 어떻게 만들었는지 묻는 질문 댓글은 답할 필요 0.92로 바로 답글이 달렸고, 장애 표현이 들어간 댓글은 사장 확인 0.86이 나와 답글 없이 저에게 넘어왔습니다.
네 번째는 Aside 루틴으로 매일 아침 8시 30분 새 메일을 분류하는 일입니다. 9월 27일부터 10월 7일까지 11일 동안 제브가 새로 판정한 메일은 162통이었고, 우선순위 0.40 이상으로 목록에 올린 것은 44통, 0.60 이상으로 알림을 보낸 것은 4번이었습니다. 광고 계정 정지 예고, 구독 만료 예고 같은 메일이었습니다.
비용은 정말 작았습니다. 10월 7일 검사기를 한 번 돌릴 때 입력 586토큰, 출력 34토큰이 나왔고, 같은 검사 두 번의 입력 1,172토큰에 공식 가격을 곱하면 약 0.066원입니다. 결제 화면에서 확인한 금액이 아니라 계산값입니다.
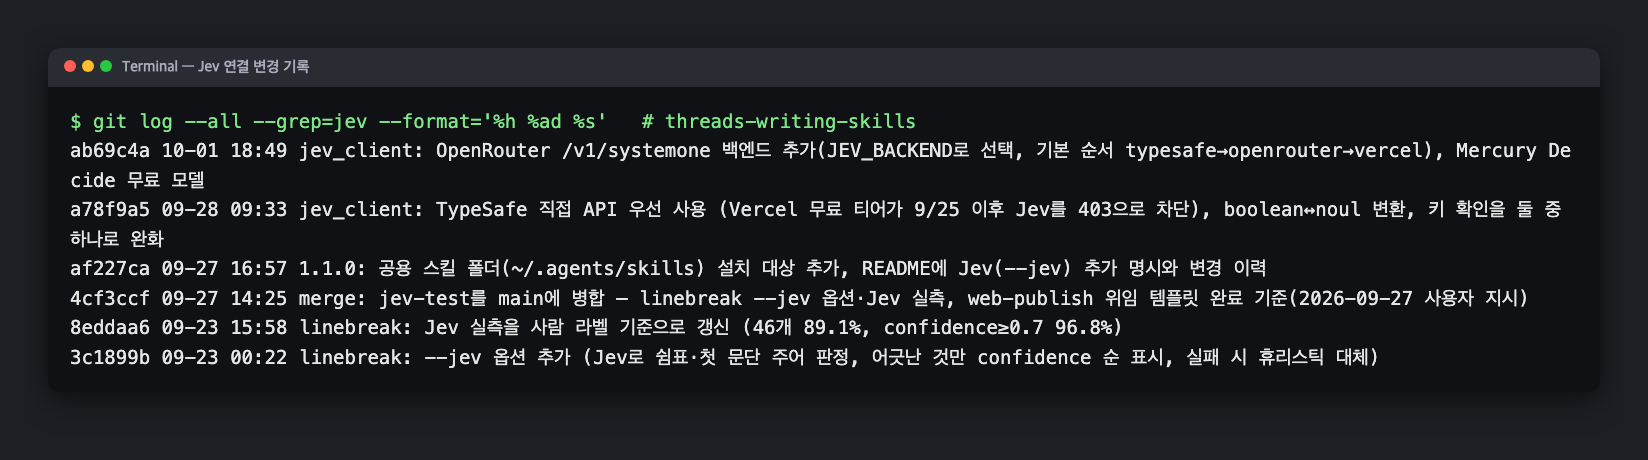
막힌 점도 있었습니다. 처음에는 버셀(Vercel) AI 게이트웨이의 무료 크레딧으로 불렀는데 9월 25일 이후 무료 사용자에게 403 오류가 나기 시작해, 9월 28일에는 메일 판정이 한 통도 되지 않았고 타입세이프 직접 API로 경로를 바꿨습니다. 같은 요금 질문 댓글이 한 번은 '사장 확인' 0.48, 다시 판정하니 0.50이 나와 기준선(0.5)을 넘나든 일도 있었습니다. 10월 7일에는 0.60 이상 메일이 없었는데 루틴이 실수로 알림을 한 번 보내기도 했습니다.
3주를 써 본 제 결론은 "더 싸고 빠르고 좋은 모델이 나오면 갈아탈거야"였습니다. 오픈AI 디시전 API가 공개된 뒤인 10월 7일까지도 아직 바꾸지는 않았습니다.
그래서 나는 써 볼 만한가요?
아래는 제 판단입니다. 의견으로 봐 주세요. 답이 몇 가지로 정해진 작은 판단을 매일 수백 번 반복한다면 써 볼 만합니다.
- 댓글·메일·문의 분류처럼 보기가 정해진 일, 다음 단계를 어느 모델이나 사람에게 넘길지 고르는 일에는 잘 맞았습니다.
- 값을 그대로 믿기보다 기준선을 정하고, 기준선 근처나 민감한 건은 사람에게 넘기는 구조가 필요합니다. 타입세이프 문서도 확신도를 보고 사람이나 추론 모델에 넘기라고 안내합니다.
- 사진을 판단해야 한다면 지금은 오픈AI 디시전 API 쪽이 맞습니다. 한국어 글이 중심이라면 어느 쪽이든 자기 데이터로 먼저 시험해 보시길 권합니다.
- 글을 써 주거나 설명해 주는 AI가 필요하다면 제브는 맞지 않습니다. 챗GPT나 클로드 같은 일반 모델이 할 일입니다.
자주 묻는 질문
제브를 쓰려면 코딩을 할 줄 알아야 하나요?
대체로 그렇습니다. 채팅 화면이 아니라 API로 부르는 모델이라 파이썬·타입스크립트 SDK나 HTTP 요청을 써야 합니다. 저도 코드는 AI 비서가 짰습니다.
정말 환각이 없나요?
정해 둔 보기 밖의 답이나 형식이 틀린 답은 나오지 않습니다. 하지만 보기 안에서 틀린 것을 고를 수는 있어서, 확률이 애매한 답은 사람이 확인하는 편이 안전합니다.
회사가 말하는 '수백 배 빠르고 싸다'는 믿을 만한가요?
공식 블로그의 193.6배 빠름, 444.6배 저렴은 회사가 직접 만든 평가에서 나온 값이고, 회사도 실제로는 이보다 덜할 수 있다고 적었습니다. 테크크런치는 버셀 엔지니어가 안전 분류를 제브로 바꿔 5~18배 빨라졌다고 전했습니다.
참고한 자료
- TypeSafe - Introducing System One Models & Jev
- TypeSafe 문서 - Models(요금·제한·언어 지원)
- OpenAI API 문서 - Decisions
- TechCrunch - A new kind of AI model from a ChatGPT inventor is thrilling developers
- The New Stack - Decision models are suddenly everywhere. OpenAI's is now public.
2026년 10월 12일 기준으로 확인한 내용입니다. 요금, 사용 제한, 지원 입력 종류는 회사 사정에 따라 바뀔 수 있으니 공식 페이지를 확인해 주세요.
'AI 도구 최신 정보' 카테고리의 다른 글
| 코덱스 GPT-6 아스트라 vs 6.1 솔: 요금·한도 비교 (0) | 2026.10.11 |
|---|---|
| 챗GPT GPT-6 인텔리전트 UI 써보니: 무료·Pro 차이 (0) | 2026.10.09 |
| 클로드 클라우드 세션 크레딧 사용 방법: 받는 법·마감·주의점 (0) | 2026.10.07 |
| 클로드 소넷 5.5 총정리: 달라진 점, 요금, 무료 사용 (0) | 2026.10.05 |
| ARTEX AI란? 신한은행 유출 서버 흔적과 내가 할 일 (0) | 2026.10.04 |

